Google không index website nghĩa là các URL của bạn chưa được lưu vào cơ sở dữ liệu tìm kiếm của Google, nên không thể xuất hiện trong kết quả dù người dùng gõ đúng tên thương hiệu. Tình trạng này có thể chỉ xảy ra với một URL, một nhóm trang hoặc toàn bộ tên miền. Bài viết này, Peak Agency giúp bạn xác định phạm vi lỗi trước, sau đó đi từng bước từ kiểm tra, tìm nguyên nhân đến khắc phục.
Mục lục bài viết
Website không được Google index là gì?
Website không được index là website có URL chưa nằm trong chỉ mục của Google, nên không đủ điều kiện xuất hiện trên kết quả tìm kiếm. Điều này khác với việc website xếp hạng thấp. Một trang đã index vẫn có thể ở trang năm mươi của kết quả, nhưng trang chưa index thì hoàn toàn không có cơ hội hiển thị. Vì vậy, bạn phải kiểm tra tình trạng index trước khi bắt tay vào sửa.
Một số dấu hiệu cho thấy website có thể đang gặp vấn đề index: tìm tên thương hiệu không thấy trang chủ, tìm một URL cụ thể không có kết quả, Search Console hiển thị cảnh báo hoặc số URL đã index sụt giảm, và lượng traffic organic giảm mạnh về gần 0. Tuy vậy, mỗi dấu hiệu chỉ là gợi ý, nên bước tiếp theo là kiểm tra chính xác bằng công cụ của Google.
Nguyên nhân Google không index website
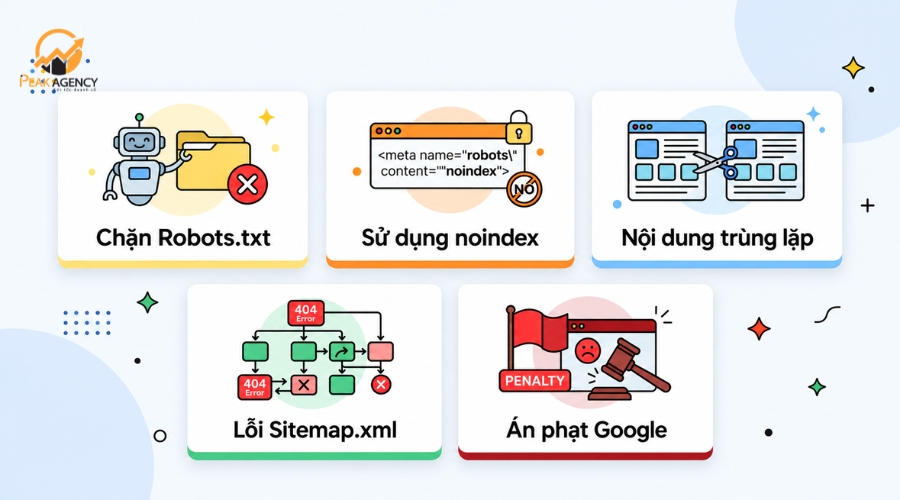
Nguyên nhân kỹ thuật khiến Google không index website
robots.txt chặn Googlebot: Một dòng Disallow sai có thể chặn cả website. Ví dụ nguy hiểm thường gặp là sau khi triển khai, file còn giữ cấu hình của môi trường thử nghiệm
User-agent: *
Disallow: /
Cấu hình này cấm mọi crawler truy cập toàn bộ website. Hãy mở tenmien.com/robots.txt để xem nội dung thật, rồi dùng URL Inspection để kiểm tra Googlebot có bị chặn hay không.
Noindex trong meta hoặc X-Robots-Tag: Chỉ thị noindex có hai vị trí đặt: thẻ meta trong HTML hoặc header HTTP X-Robots-Tag. Ví dụ thẻ meta là <meta name=”robots” content=”noindex”>. Để biết Googlebot thực sự nhận được gì, hãy dùng Test Live URL và xem HTML cùng thông tin phản hồi, thay vì chỉ dựa vào mã nguồn bạn thấy trong trình duyệt, vì plugin hoặc cấu hình máy chủ có thể chèn chỉ thị ở tầng khác.
WordPress “Discourage search engines”: WordPress có tùy chọn “Discourage search engines from indexing this site” tại Settings → Reading. Khi bật, website gửi tín hiệu yêu cầu công cụ tìm kiếm không index. Lỗi hay gặp là bản staging được bật tùy chọn này rồi sao chép nguyên sang website chính (kinh nghiệm thực tế). Hãy tắt tùy chọn, lưu lại và kiểm tra bằng URL Inspection.
Canonical sai hoặc mâu thuẫn: Khi thẻ canonical trỏ một URL, sitemap liệt kê URL khác và internal link lại dùng URL thứ ba, Google nhận tín hiệu mâu thuẫn và có thể tự chọn phiên bản. Hãy kiểm tra ba điểm: thẻ canonical, URL trong sitemap và liên kết nội bộ phải cùng trỏ về một URL duy nhất, đúng giao thức, đúng tên miền có hoặc không có www.
JavaScript: Nếu nội dung chỉ xuất hiện sau khi trình duyệt chạy script, hoặc liên kết không phải thẻ <a href> thật, Google có thể thấy trang thiếu nội dung hoặc không khám phá được các URL con. Hãy dùng URL Inspection để xem HTML đã render và đối chiếu với nội dung bạn kỳ vọng. Nếu nội dung quan trọng không có trong bản render, hãy cân nhắc server-side rendering hoặc pre-rendering.
Phiên bản mobile thiếu nội dung: Google dùng nguyên tắc mobile-first indexing, nghĩa là chủ yếu dùng phiên bản mobile của trang để lập chỉ mục (Google xác nhận). Nếu bản mobile ẩn bớt nội dung, thiếu liên kết hoặc thiếu dữ liệu có cấu trúc so với bản desktop, trang có thể bị đánh giá kém. Hãy so sánh hai phiên bản và đảm bảo nội dung chính giống nhau.
Nguyên nhân khiến Google không khám phá được URL
Nếu Google không thấy URL thì chưa thể index, nên nhóm nguyên nhân này nằm ở giai đoạn khám phá. Google tìm URL chủ yếu qua sitemap và liên kết, vì vậy một trang không được khai báo hoặc không có liên kết nào trỏ tới sẽ rất khó được phát hiện. Các nguyên nhân dưới đây giải thích vì sao điều đó xảy ra.
Website mới chưa khai báo Search Console
Website mới chưa có tín hiệu nào với Google. Hãy thực hiện ba bước:
- Xác minh tên miền trong Google Search Console.
- Gửi sitemap tại mục Sitemaps.
- Theo dõi báo cáo crawl và Page indexing trong những ngày tiếp theo.
Sitemap có vấn đề
| Lỗi sitemap thường gặp | Cách sửa |
| Chứa URL trả lỗi 404, 5xx | Loại URL lỗi khỏi sitemap |
| Chứa URL bị redirect | Thay bằng URL đích cuối cùng |
| Chứa URL có noindex | Bỏ URL khỏi sitemap hoặc gỡ noindex nếu cần index |
| Chứa URL non-canonical | Chỉ giữ URL canonical |
Sau khi chỉnh sửa, hãy gửi lại sitemap và theo dõi trạng thái xử lý trong Search Console.
Trang mồ côi, internal link yếu: Trang mồ côi là trang không có liên kết nội bộ nào trỏ tới, nên Googlebot chỉ có thể biết đến nó qua sitemap, nếu có. Ví dụ, một bài hướng dẫn mới đăng nhưng không được liên kết từ trang chủ, danh mục hay bài liên quan sẽ rất dễ bị bỏ sót. Cách khắc phục là thêm liên kết từ các trang mạnh, đặt trong ngữ cảnh tự nhiên với anchor text mô tả đúng nội dung.
Cấu trúc sâu, URL tham số
- Trang nằm quá sâu, cần nhiều lần click mới tới, thường ít được crawl hơn.
- Bộ lọc và tham số có thể sinh ra vô số URL không cần thiết, làm loãng tín hiệu.
Website lớn, ngân sách crawl: Crawl budget chỉ là vấn đề đáng quan tâm với website lớn, có hàng trăm nghìn URL trở lên hoặc nội dung thay đổi liên tục, theo hướng dẫn của Google (Google xác nhận). Với website nhỏ, vấn đề này hiếm khi là nguyên nhân chính. Đừng lo lắng sai chỗ: hãy kiểm tra các lỗi kỹ thuật và chất lượng nội dung trước.
Nguyên nhân từ chất lượng nội dung
URL đã được Google thấy nhưng chưa đủ giá trị để đưa vào chỉ mục là tình huống rất phổ biến, đặc biệt với trạng thái Crawled – currently not indexed. Theo hướng dẫn về nội dung hữu ích của Google (Google xác nhận), nội dung nên được viết cho người đọc chứ không phải cho công cụ tìm kiếm. Hãy tự hỏi: trang này có điều gì mà các trang đang xếp hạng chưa có?
Nội dung mỏng, trùng lặp, gần giống: Trang chỉ có vài dòng, hoặc nhiều trang gần như giống hệt nhau, khiến Google khó thấy lý do để lưu từng trang. Để phát hiện trùng lặp nội bộ, hãy dùng công cụ crawl để so sánh tiêu đề, nội dung và đoạn mô tả. Khi tìm thấy các trang gần giống, hãy hợp nhất chúng thành một trang mạnh hơn, hoặc khai báo canonical về trang đại diện.
Không đáp ứng ý định tìm kiếm: Một trang có thể đúng chủ đề nhưng sai ý định. Ví dụ, người dùng tìm “cách kiểm tra index” muốn hướng dẫn từng bước, trong khi trang của bạn chỉ có định nghĩa chung chung. Hãy tìm từ khóa mục tiêu, xem các kết quả đầu trang đang trả lời theo dạng nào, rồi điều chỉnh cấu trúc và độ sâu nội dung để đáp ứng đúng nhu cầu.
Nội dung tạo hàng loạt: Nội dung sản xuất hàng loạt, ít kiểm duyệt và không bổ sung giá trị riêng có thể bị Google xem là spam, theo chính sách spam của Google (Google xác nhận). Dấu hiệu gồm hàng trăm bài có cấu trúc giống nhau và thông tin lặp lại. Hướng sửa là rà soát từng nhóm bài, bổ sung dữ liệu, ví dụ, góc nhìn chuyên môn riêng, và gỡ những trang không còn giá trị.
Thiếu tín hiệu tin cậy: Các tín hiệu tin cậy giúp Google và người đọc đánh giá website, đặc biệt với chủ đề nhạy cảm. Hãy kiểm tra các yếu tố sau (kinh nghiệm thực tế, liên hệ với khung E-E-A-T trong tài liệu của Google):
- Tác giả rõ ràng, có thông tin chuyên môn.
- Nguồn tham khảo cho các nhận định quan trọng.
- Thông tin liên hệ và chính sách minh bạch.
- Ngày cập nhật nội dung.
Trang không cần URL riêng: Không phải trang nào cũng xứng đáng có URL riêng được index. Các trang thẻ, bộ lọc hoặc phiên bản gần như giống nhau nên được gộp vào trang chính, redirect 301 hoặc đặt noindex nếu chủ ý không cho xuất hiện. Việc này giảm số URL kém giá trị và giúp Google tập trung vào những trang quan trọng.
Nguyên nhân từ bảo mật và xử phạt
Nếu mọi nhóm trên đều ổn mà toàn site vẫn không index, hãy kiểm tra nhóm này. Các vấn đề bảo mật và hình phạt thủ công là nguyên nhân ít gặp hơn nhưng ảnh hưởng nặng nề, và Search Console có báo cáo riêng cho từng loại. Bảng dưới đây giúp bạn xác định nhanh.
Manual Action: Manual Action là hình phạt do nhân viên của Google áp dụng khi website vi phạm chính sách. Hãy vào Search Console, mở mục Manual actions để xem thông báo. Nếu có, hãy sửa vấn đề được nêu, ghi lại các việc đã làm và gửi yêu cầu xem xét lại theo hướng dẫn của Google (Google xác nhận).
Website bị hack: Website bị hack thường có dấu hiệu như xuất hiện URL lạ, nội dung spam bị chèn vào, hoặc mã độc ẩn trong tệp. Bạn nên kiểm tra thủ công mã nguồn, danh sách URL trong sitemap và Page indexing report. Sau khi làm sạch, hãy cập nhật mật khẩu, vá lỗ hổng và theo dõi lại báo cáo.
Security Issues: Báo cáo Security Issues cảnh báo về phần mềm độc hại hoặc nội dung lừa đảo trên website. Khi nhận cảnh báo, hãy khôi phục từ bản sao lưu sạch, loại bỏ mã độc, đóng lỗ hổng rồi gửi yêu cầu xem xét lại trong Search Console. Không nên bỏ qua cảnh báo vì nó ảnh hưởng đến cả người dùng và khả năng hiển thị.
Vi phạm chính sách spam: Các hành vi như nhồi nhét từ khóa, nội dung vô nghĩa, chuyển hướng gây hiểu lầm hay lạm dụng nội dung tự động có thể bị coi là spam. Hướng khắc phục là gỡ các nội dung vi phạm, thay bằng nội dung có giá trị thực và theo dõi phản hồi. Lưu ý, không mặc định cho rằng backlink hay PBN là nguyên nhân nếu chưa có bằng chứng cụ thể.
Xem thêm: Cách kiểm tra website có bị Google phạt
Quy trình khắc phục Google không index website
Khi Google không index website, bạn không nên gửi yêu cầu lập chỉ mục liên tục mà chưa xác định nguyên nhân. Hãy bắt đầu từ trạng thái được báo trong Search Console và xử lý theo thứ tự từ kỹ thuật đến nội dung. Quy trình dưới đây gồm 7 bước giúp kiểm tra khả năng crawl, index, canonical, sitemap và chất lượng trang.
Bước 1. Xác định phạm vi và trạng thái URL
Trước tiên, hãy tổng hợp những URL đang gặp vấn đề và kiểm tra trạng thái của chúng trong báo cáo Page indexing trên Google Search Console. Việc xác định lỗi xảy ra ở một URL, một nhóm URL, một thư mục hay toàn bộ website sẽ giúp khoanh vùng nguyên nhân nhanh hơn. Sau bước này, bạn cần biết trang đang bị noindex, chặn robots.txt, chưa được index, gặp lỗi canonical hay vấn đề khác để chuyển sang bước xử lý phù hợp.
Bước 2. Kiểm tra bằng Test Live URL
Sau khi xác định URL gặp vấn đề, hãy mở URL Inspection trong Search Console và sử dụng Test Live URL để kiểm tra phiên bản hiện tại của trang. Đối chiếu kết quả live với dữ liệu Google đã ghi nhận nhằm phát hiện các lỗi như bị chặn crawl, tải trang thất bại, chứa thẻ noindex hoặc canonical không đúng.
Bước 3. Gỡ chặn robots.txt và thẻ noindex
Nếu trang quan trọng đang bị chặn bởi robots.txt hoặc chứa thẻ noindex, hãy sửa cấu hình trước khi thực hiện các tối ưu khác. Ví dụ, Disallow: / có thể ngăn bot truy cập toàn website, trong khi thẻ noindex khiến Google không đưa trang vào chỉ mục. Hãy giới hạn robots.txt đúng thư mục cần chặn và loại bỏ noindex khỏi URL cần xuất hiện.
Bước 4. Kiểm tra canonical, redirect và HTTP status
Canonical hoặc chuyển hướng cấu hình sai có thể khiến Google lựa chọn một URL khác thay vì trang bạn muốn lập chỉ mục. Hãy kiểm tra trang có nhiều canonical, redirect qua nhiều bước, soft 404 hoặc tồn tại đồng thời nhiều phiên bản như HTTP, HTTPS, www và non-www hay không.
Bước 5. Tối ưu sitemap và internal link
Sitemap nên chỉ chứa những URL canonical, có thể index và trả về mã trạng thái 200 để Google nhận diện đúng các trang quan trọng. Đồng thời, hãy bổ sung internal link theo ngữ cảnh từ những trang có liên quan và đã được Google index đến URL đang gặp vấn đề. Tránh tạo các trang gần như biệt lập mà không có liên kết nội bộ trỏ tới.
Bước 6. Nâng cấp chất lượng nội dung
Nếu Google đã crawl nhưng vẫn chưa index, vấn đề có thể nằm ở giá trị của nội dung thay vì kỹ thuật. Không nên chỉ kéo dài bài viết để tăng số lượng từ; hãy bổ sung thông tin riêng, ví dụ thực tế, dữ liệu, kinh nghiệm và nguồn tham khảo phù hợp. Đồng thời kiểm tra trang có đáp ứng đúng search intent, trùng lặp với URL khác hay quá ít giá trị riêng hay không.
Bước 7. Yêu cầu index và tiếp tục theo dõi
Sau khi sửa hoàn chỉnh các lỗi, bạn có thể sử dụng Request Indexing trong URL Inspection cho những trang quan trọng cần Google thu thập lại. Hãy ghi lại ngày sửa, ngày gửi yêu cầu và trạng thái URL để thuận tiện theo dõi thay vì gửi lại liên tục. Trong những ngày tiếp theo, kiểm tra Page indexing và URL Inspection để xem Google đã crawl lại hay chưa.
Lời kết
Tình trạng Google không index website có thể xuất phát từ nhiều nguyên nhân như cấu hình robots.txt sai, thẻ noindex, sitemap chưa chuẩn, lỗi canonical, chất lượng nội dung thấp hoặc website gặp vấn đề kỹ thuật trong quá trình thu thập dữ liệu. Nếu không xử lý sớm, các trang quan trọng sẽ khó xuất hiện trên kết quả tìm kiếm và ảnh hưởng trực tiếp đến traffic tự nhiên.
Nếu website của bạn đang gặp lỗi index nhưng chưa xác định được nguyên nhân, Peak Agency có thể hỗ trợ Audit kỹ thuật, kiểm tra khả năng crawl và index, đồng thời đề xuất lộ trình tối ưu phù hợp. Liên hệ Peak Agency để được tư vấn giải pháp giúp Google thu thập dữ liệu hiệu quả hơn, cải thiện khả năng hiển thị và tạo nền tảng SEO bền vững cho website.
Xem thêm: Dịch vụ Technical SEO